
Author
Article written by Shivani Shah, CTO & Co-founder at Samp
Dada la situación actual del mercado, existen numerosas herramientas con flujos de trabajo muy consolidados para anotar y gestionar datos de entrenamiento de IA. Sin embargo, en Samp hemos optado por desarrollar internamente herramientas a medida para llevar a cabo esta tarea, lo cual puede resultar muy complicado. Por lo tanto, el objetivo de este artículo es describir el razonamiento que subyace a esta decisión, al tiempo que se pone de manifiesto la complejidad subyacente de la tarea.
Ámbitos como los vehículos autónomos, la cartografía de territorios geográficos y el interior de edificios, entre otros, también requieren la anotación de grandes cantidades de datos LIDAR en 3D. Sin embargo, este mercado es más reducido que el de las imágenes en 2D y las necesidades de anotación también están fragmentadas, por lo que existen muchas menos herramientas desarrolladas con el fin de etiquetar nubes de puntos.
¿Qué tipo de anotación de datos se requiere en las nubes de puntos?
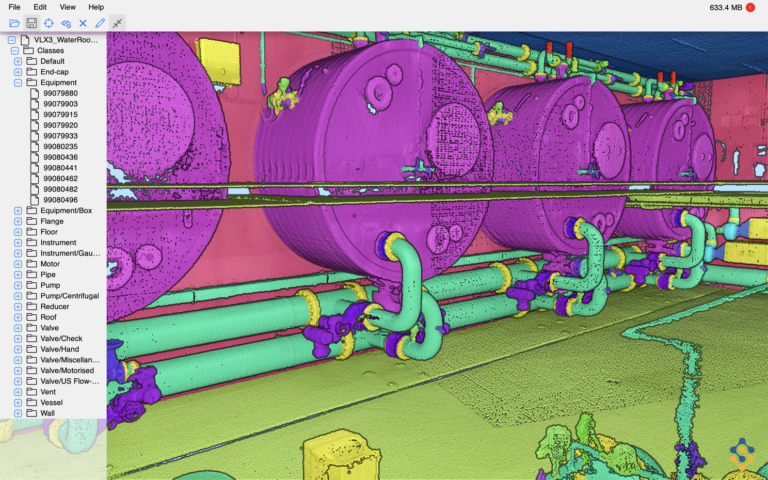
La función de la IA 3D para el producto «Shared Reality» de Samp consiste en detectar una instancia de un objeto y predecir su clase semántica, lo que también se conoce como «segmentación panóptica». Por lo tanto, para el etiquetado de datos, debemos separar cada objeto de la escena y asignarle la instancia y la etiqueta semántica correspondientes.
Comenzamos con programas de código abierto como Cloud Compare y, posteriormente, pasamos a utilizar Leica Cyclone cuando los conjuntos de datos aumentaron de tamaño. Una tarea de anotación de este tipo requiere conocimientos especializados sobre los objetos presentes en el entorno industrial, por lo que era importante elegir un software con el que los expertos en la materia se sintieran cómodos. Sin embargo, finalmente diseñamos nuestra propia herramienta para llevar a cabo la tarea.

1. El enorme volumen de datos industriales
Desde que comenzamos a gestionar datos reales de clientes, nos vimos obligados a anotar escaneos que contienen miles de millones de puntos por emplazamiento. En conjunto, se trata de petabytes de datos de nubes de puntos que deben procesarse. Esto ralentizó la mayoría de las operaciones, y la mera transferencia de datos entre dos ubicaciones podía llevar horas.
La mayoría de las herramientas de anotación de datos de IA admiten hasta unos pocos millones de puntos. Esto resulta suficiente para el mercado de los vehículos autónomos, principalmente porque estos utilizan nubes de puntos muy dispersas. En cambio, las nubes de puntos industriales con las que trabajamos requieren una densidad de puntos mucho mayor, lo que da lugar a archivos de tamaño muy grande.
Con programas industriales como Cyclone, el rendimiento comienza a ralentizarse significativamente con este volumen de datos. Se acumulan muchos minutos de tiempo de espera y, finalmente, el sistema acaba fallando. Dado que no son de código abierto, tampoco es posible comprender los cuellos de botella ni mejorar ninguna de sus funciones por nuestra cuenta.
Con el objetivo de acelerar todo el proceso de anotación, identificamos las siguientes tareas que debían abordarse:
- Hacer que la herramienta de anotación pueda gestionar archivos de datos de mayor tamaño
- Centralizar el flujo de datos para evitar numerosas transferencias
- Acelerar la velocidad de lectura, escritura y transferencia de los datos
Gracias a los miembros del equipo de Samp, dotados de una habilidad extraordinaria, logramos alcanzar los objetivos mencionados creando nuestra propia herramienta de anotación, capaz de gestionar archivos de datos mucho más grandes.
Esto dio lugar a desarrollos técnicos internos muy especiales, como:
- Formato de archivo personalizado. Nuestro querido «Samp-point-Z». Está diseñado para contener toda la información necesaria para el entrenamiento de la IA, como, por ejemplo, las etiquetas de los objetos. Esto redujo el número de operaciones de lectura y escritura.
- Algoritmo de compresión personalizado. Está diseñado específicamente para la densidad de las nubes de puntos que requiere la IA y la calidad visual de los productos de Samp. Resulta más adecuado que Draco, ya que no se produce pérdida de datos en las operaciones de lectura y escritura. Nos proporcionó aproximadamente un 30 % más de compresión de datos que los formatos abiertos como .e57.
- Centralización del flujo de datos. Al controlar el proceso de principio a fin, podemos diseñar formas óptimas de transferir datos entre los diferentes pasos del proceso de anotación. Empezando por la verificación de datos, la segmentación, el etiquetado y los controles de calidad para QaQC.
Donde la integridad física se une a la integridad de la información
2. Seguridad de los datos
Los datos industriales son sensibles y existen normativas estrictas para evitar cualquier filtración de la información sobre los activos. Esto siempre ha supuesto un reto a la hora de transferir datos a herramientas de terceros. Sin embargo, en el proceso recientemente diseñado, controlamos la autenticación de los usuarios. Además, los datos nunca salen del servidor ni de las herramientas de Samp, lo que garantiza una mayor seguridad de los datos para los clientes.
3. Aceleración del proceso de anotación de datos mediante el aprovechamiento de la IA interna.
Es una práctica habitual en las herramientas de anotación en 2D pre-segmentar los datos utilizando IA en segundo plano para facilitar la selección de las regiones que se van a etiquetar. De manera similar, se ha aplicado la misma analogía al 3D, donde se ha aprovechado la IA desarrollada internamente en la herramienta de anotación para presegmentar los datos en grupos correspondientes a la instancia deseada.
La principal ventaja aquí radica en el ahorro de tiempo, ya que la IA ya se encarga de gran parte del trabajo pesado, reduciendo el tiempo a la mitad.
4. Gestión de las variaciones en los datos
Dado que estamos implementando la solución en diferentes categorías de industrias pesadas, como el agua, los residuos, la energía, etc., observamos algunas diferencias en el proceso. Normalmente, estas se dan en la taxonomía, los tipos de datos, los formatos de datos, la oclusión, la densidad, etc.
Contar con nuestra propia herramienta de anotación de datos nos proporciona la flexibilidad suficiente para adaptarnos de manera eficiente a las necesidades cambiantes y nos ayuda a ampliar nuestra presencia en distintas industrias.
5. Comercialización y participación humana
La visión de las empresas que implementan modelos de visión artificial es pasar de «manual» a «IA parcial» y, finalmente, a «solo IA». Sin embargo, los errores en este ámbito pueden tener consecuencias peligrosas para la seguridad en estas instalaciones. Por ello, los seres humanos deben verificar y, si es necesario, corregir los resultados de los modelos de IA antes de la entrega final.
Al conectar la herramienta de anotación de datos a la plataforma web de Samp, hemos habilitado la capacidad de realizar correcciones en los datos del cliente… facilitando así la «intervención humana en el proceso».
Todas las empresas de IA se enfrentan a retos específicos a la hora de obtener los datos etiquetados necesarios; estaríamos encantados de ponernos en contacto e intercambiar opiniones sobre este tema.

